Что такое robots.txt и зачем вообще нужен индексный файл

Файл robots.txt вместе с xml-картой несёт, пожалуй, самую важную информацию о ресурсе: он показывает роботам поисковых систем, как именно «читать» сайт, какие страницы важны, а какие следует пропустить. Еще robots.txt — первая страница, на которую стоит смотреть, если на сайт внезапно упал трафик.
Что за роботс ти экс ти?
Файл robots.txt или индексный файл — обычный текстовый документ в кодировке UTF-8, действует для протоколов http, https, а также FTP. Файл дает поисковым роботам рекомендации: какие страницы/файлы стоит сканировать. Если файл будет содержать символы не в UTF-8, а в другой кодировке, поисковые роботы могут неправильно их обработать. Правила, перечисленные в файле robots.txt, действительны только в отношении того хоста, протокола и номера порта, где размещен файл.
Файл должен располагаться в корневом каталоге в виде обычного текстового документа и быть доступен по адресу: https://site.com.ru/robots.txt.
В других файлах принято ставить отметку ВОМ (Byte Order Mark). Это Юникод-символ, который используется для определения последовательности в байтах при считывании информации. Его кодовый символ — U+FEFF. В начале файла robots.txt отметка последовательности байтов игнорируется.
Google установил ограничение по размеру файла robots.txt — он не должен весить больше 500 Кб.
Ладно, если вам интересны сугубо технические подробности, файл robots.txt представляет собой описание в форме Бэкуса-Наура (BNF). При этом используются правила RFC 822.
При обработке правил в файле robots.txt поисковые роботы получают одну из трех инструкций:
- частичный доступ: доступно сканирование отдельных элементов сайта;
- полный доступ: сканировать можно все;
- полный запрет: робот ничего не может сканировать.
При сканировании файла robots.txt роботы получают такие ответы:
- 2xx — сканирование прошло удачно;
- 3xx — поисковый робот следует по переадресации до тех пор, пока не получит другой ответ. Чаще всего есть пять попыток, чтобы робот получил ответ, отличный от ответа 3xx, затем регистрируется ошибка 404;
- 4xx — поисковый робот считает, что можно сканировать все содержимое сайта;
- 5xx — оцениваются как временные ошибки сервера, сканирование полностью запрещается. Робот будет обращаться к файлу до тех пор, пока не получит другой ответ.Поисковый робот Google может определить, корректно или некорректно настроена отдача ответов отсутствующих страниц сайта, то есть, если вместо 404 ошибки страница отдает ответ 5xx, в этом случае страница будет обpaбатываться с кодом ответа 404.
Пока что неизвестно, как обpaбатывается файл robots.txt, который недоступен из-за проблем сервера с выходом в интернет.
Зачем нужен файл robots.txt
Например, иногда роботам не стоит посещать:
- страницы с личной информацией пользователей на сайте;
- страницы с разнообразными формами отправки информации;
- сайты-зеркала;
- страницы с результатами поиска.
Важно: даже если страница находится в файле robots.txt, существует вероятность, что она появится в выдаче, если на неё была найдена ссылка внутри сайта или где-то на внешнем ресурсе.
Так роботы поисковых систем видят сайт с файлом robots.txt и без него:
Без robots.txt та информация, которая должна быть скрыта от посторонних глаз, может попасть в выдачу, а из-за этого пострадаете и вы, и сайт.
Так робот поисковых систем видит файл robots.txt:
Google обнаружил файл robots.txt на сайте и нашел правила, по которым следует сканировать страницы сайта
Как создать файл robots.txt
С помощью блокнота, Notepad, Sublime, либо любого другого текстового редактора.
В содержании файла должны быть прописаны инструкция User-agent и правило Disallow, к тому же есть еще несколько второстепенных правил.
User-agent — визитка для роботов
User-agent — правило о том, каким роботам необходимо просмотреть инструкции, описанные в файле robots.txt. На данный момент известно 302 поисковых робота. Чтобы не прописывать всех по отдельности, стоит использовать запись:
Она говорит о том, что мы указываем правила в robots.txt для всех поисковых роботов.
Для Google главным роботом является Googlebot. Если мы хотим учесть только его, запись в файле будет такой:
В этом случае все остальные роботы будут сканировать контент на основании своих директив по обработке пустого файла robots.txt.
Для Yandex главным роботом является... Yandex:
Другие специальные роботы:
- Mediapartners-Google — для сервиса AdSense;
- AdsBot-Google — для проверки качества целевой страницы;
- YandexImages — индексатор Яндекс.Картинок;
- Googlebot-Image — для картинок;
- YandexMetrika — робот Яндекс.Метрики;
- YandexMedia — робот, индексирующий мультимедийные данные;
- YaDirectFetcher — робот Яндекс.Директа;
- Googlebot-Video — для видео;
- Googlebot-Mobile — для мобильной версии;
- YandexDirectDyn — робот генерации динамических баннеров;
- YandexBlogs — робот поиск по блогам, индексирующий посты и комментарии;
- YandexMarket— робот Яндекс.Маркета;
- YandexNews — робот Яндекс.Новостей;
- YandexDirect — скачивает информацию о контенте сайтов-партнеров Рекламной сети, чтобы уточнить их тематику для подбора релевантной рекламы;
- YandexPagechecker — валидатор микроразметки;
- YandexCalendar — робот Яндекс.Календаря.
Disallow — расставляем «кирпичи»
Disallow дает рекомендацию, какую именно информацию не стоит сканировать.
Такая запись открывает для сканирования весь сайт:
А эта запись говорит о том, что абсолютно весь контент на сайте запрещен для сканирования:
Ее стоит использовать, если сайт находится в процессе доработок, и вы не хотите, чтобы он в нынешнем состоянии засветился в выдаче.
Важно снять это правило, как только сайт будет готов к тому, чтобы его увидели пользователи. К сожалению, об этом забывают многие вебмастера.
Пример. Как прописать правило Disallow, чтобы дать инструкции роботам не просматривать содержимое папки /papka/:
Чтобы роботы не сканировали конкретный URL:
Чтобы роботы не сканировали конкретный файл:
Чтобы роботы не сканировали все файлы определенного разрешения на сайте:
Данная строка запрещает индексировать все файлы с расширением .gif
Allow — направляем роботов
Allow разрешает сканировать какой-либо файл/директиву/страницу. Допустим, необходимо, чтобы роботы могли посмотреть только страницы, которые начинались бы с /catalog, а весь остальной контент закрыть. В этом случае прописывается следующая комбинация:
Правила Allow и Disallow сортируются по длине префикса URL (от меньшего к большему) и применяются последовательно. Если для страницы подходит несколько правил, робот выбирает последнее правило в отсортированном списке.
Host — выбираем зеркало сайта
Host — одно из обязательных для robots.txt правил, оно сообщает роботу Яндекса, какое из зеркал сайта стоит учитывать для индексации.
Зеркало сайта — точная или почти точная копия сайта, доступная по разным адресам.
Робот не будет путаться при нахождении зеркал сайта и поймет, что главное зеркало указано в файле robots.txt. Адрес сайта указывается без приставки «https://», но если сайт работает на HTTPS, приставку «https://» указать нужно.
Как необходимо прописать это правило:
Пример файла robots.txt, если сайт работает на протоколе HTTPS:
Sitemap — медицинская карта сайта
Sitemap сообщает роботам, что все URL сайта, обязательные для индексации, находятся по адресу https://site.ru/sitemap.xml. При каждом обходе робот будет смотреть, какие изменения вносились в этот файл, и быстро освежать информацию о сайте в базах данных поисковой системы.
Инструкция должна быть грамотно вписана в файл:
Crawl-delay — секундомер для слабых серверов
Crawl-delay — параметр, с помощью которого можно задать период, через который будут загружаться страницы сайта. Данное правило актуально, если у вас слабый сервер. В таком случае возможны большие задержки при обращении поисковых роботов к страницам сайта. Этот параметр измеряется в секундах.
Clean-param — охотник за дублирующимся контентом
Clean-param помогает бороться с get-параметрами для избежания дублирования контента, который может быть доступен по разным динамическим адресам (со знаками вопроса). Такие адреса появляются, если на сайте есть различные сортировки, id сессии и так далее.
Допустим, страница доступна по адресам:
www.site.com/catalog/get_phone.ru?ref=page_1&phone_id=1
www.site.com/catalog/get_phone.ru?ref=page_2&phone_id=1
www.site.com/catalog/get_phone.ru?ref=page_3&phone_id=1
В таком случае файл robots.txt будет выглядеть так:
Здесь ref указывает, откуда идет ссылка, поэтому она записывается в самом начале, а уже потом указывается остальная часть адреса.
Но прежде чем перейти к эталонному файлу, необходимо еще узнать о некоторых знаках, которые применяются при написании файла robots.txt.
Символы в robots.txt
Основные символы файла — «/, *, $, #».
С помощью слэша «/» мы показываем, что хотим закрыть от обнаружения роботами. Например, если стоит один слеш в правиле Disallow, мы запрещаем сканировать весь сайт. С помощью двух знаков слэш можно запретить сканирование какой-либо отдельной директории, например: /catalog/.
Такая запись говорит, что мы запрещаем сканировать все содержимое папки catalog, но если мы напишем /catalog, запретим все ссылки на сайте, которые будут начинаться на /catalog.
Звездочка «*» означает любую последовательность символов в файле. Она ставится после каждого правила.
Эта запись говорит, что все роботы не должны индексировать любые файлы с расширением .gif в папке /catalog/
Знак доллара « ограничивает действия знака звездочки. Если необходимо запретить все содержимое папки catalog, но при этом нельзя запретить урлы, которые содержат /catalog, запись в индексном файле будет такой:
Решетка «#» используется для комментариев, которые вебмастер оставляет для себя или других вебмастеров. Робот не будет их учитывать при сканировании сайта.
Например:
Как выглядит идеальный robots.txt
Такой файл robots.txt можно разместить почти на любом сайте:
Файл открывает содержимое сайта для индексирования, прописан хост и указана карта сайта, которая позволит поисковым системам всегда видеть адреса, которые должны быть проиндексированы. Отдельно прописаны правила для Яндекса, так как не все роботы понимают инструкцию Host.
Но не спешите копировать содержимое файл к себе — для каждого сайта должны быть прописаны уникальные правила, которые зависит от типа сайта и CMS. поэтому тут стоит вспомнить все правила при заполнении файла robots.txt.
Как проверить файл robots.txt
Если хотите узнать, правильно ли заполнили файл robots.txt, проверьте его в инструментах вебмастеров Google и Яндекс. Просто введите исходный код файла robots.txt в форму по ссылке и укажите проверяемый сайт.
Как не нужно заполнять файл robots.txt
Часто при заполнении индексного файла допускаются досадные ошибки, причем они связаны с обычной невнимательностью или спешкой. Чуть ниже — чарт ошибок, которые я встречала на пpaктике.
1. Перепyтaнные инструкции:
Правильный вариант:
2. Запись нескольких папок/директорий в одной инструкции Disallow:
Такая запись может запутать поисковых роботов, они могут не понять, что именно им не следует индексировать: то ли первую папку, то ли последнюю, — поэтому нужно писать каждое правило отдельно.
3. Сам файл должен называться только robots.txt, а не Robots.txt, ROBOTS.TXT или как-то иначе.
4. Нельзя оставлять пустым правило User-agent — нужно сказать, какой робот должен учитывать прописанные в файле правила.
5. Лишние знаки в файле (слэши, звездочки).
6. Добавление в файл страниц, которых не должно быть в индексе.
Нестандартное применение robots.txt
Кроме прямых функций индексный файл может стать площадкой для творчества и способом найти новых сотрудников.
Вот сайт, в котором robots.txt сам является маленьким сайтом с рабочими элементами и даже рекламным блоком.
Хотите что-то поинтереснее? Ловите ссылку на robots.txt со встроенной игрой и музыкальным сопровождением.
Многие бренды используют robots.txt, чтобы еще раз заявить о себе:
В качестве площадки для поиска специалистов файл используют в основном SEO-агентства. А кто же еще может узнать о его существовании? :)
А у Google есть специальный файл humans.txt, чтобы вы не допускали мысли о дискриминации специалистов из кожи и мяса.
Когда у вебмастера появляется достаточно свободного времени, он часто тратит его на модернизацию robots.txt:
Хотите, чтобы все страницы вашего сайта заходили в индекс быстро? Мы выберем для вас оптимальную стратегию SEO-продвижения:
Хочу быстро найти клиентов онлайнВыводы
С помощью Robots.txt вы сможете задавать инструкции поисковым роботам, рекламировать себя, свой бренд, искать специалистов. Это большое поле для экспериментов. Главное, помните о грамотном заполнении файла и типичных ошибках.
Правила, они же директивы, они же инструкции файла robots.txt:
- User-agent — правило о том, каким роботам необходимо просмотреть инструкции, описанные в robots.txt.
- Disallow дает рекомендацию, какую именно информацию не стоит сканировать.
- Sitemap сообщает роботам, что все URL сайта, обязательные для индексации, находятся по адресу https://site.ru/sitemap.xml.
- Crawl-delay — параметр, с помощью которого можно задать период, через который будут загружаться страницы сайта.
- Host сообщает роботу Яндекса, какое из зеркал сайта стоит учитывать для индексации.
- Allow разрешает сканировать какой-либо файл/директиву/страницу.
- Clean-param помогает бороться с get-параметрами для избежания дублирования контента.
Знаки при составлении robots.txt:
- Знак доллара « ограничивает действия знака звездочки.
- С помощью слэша «/» мы показываем, что хотим закрыть от обнаружения роботами.
- Звездочка «*» означает любую последовательность символов в файле. Она ставится после каждого правила.
- Решетка «#» используется, чтобы обозначить комментарии, которые пишет вебмастер для себя или других вебмастеров.
Используйте индексный файл с умом — и сайт всегда будет в выдаче.
Комментарии:
Безопасность Instagram — что делать, если заметили попытку взломщиков украсть аккаунт, и как вернуть аккаунт после взлома....
02 11 2026 16:36:56
Сезонность — повторяющиеся колебания трафика сайта в зависимости от различных внешних факторов....
01 11 2026 7:13:14
 Корневой каталог это папка, содержащая все файлы на сайте, в том числе системные файлы....
31 10 2026 3:31:52
 Как быстро увеличить количество заинтересованных подписчиков в facebook, twitter, google+ и linkedIn с помощью контактов из рассылки и аккаунтов Facebook....
30 10 2026 21:40:34
Экспорт/импорт с помощью Excel-файла или таблиц Google позволит скопировать и перенести кампании, группы объявлений и объявления в Facebook вместе с креативами, текстами, ссылками и utm-метками...
29 10 2026 2:35:59
 При наложении санкций на сайт его страницы заметно понижаются в выдаче. При наличии бана ресурс полностью исчезает из поиска, включая брендовые запросы...
28 10 2026 3:17:22
 Анализ цены за клик в 25 тематиках и 852 городах Украины, России, Казахстана, Болгарии...
27 10 2026 2:34:12
 Как определить и повысить качество парсинга ключевых слов — лайфхак с применением Microsoft Excel....
26 10 2026 4:22:44
 29 ноября в Киеве в UNIT.City — конференция по медицинскому маркетингу MeDiConf...
25 10 2026 19:23:21
 Кейсы с наибольшим количеством комментариев, репостов, оценок и дочитываний; по контекстной рекламе, поисковому продвижению, аналитике, SMM и другие. Узнать больше!...
24 10 2026 20:38:22
О работе внутреннего и внешнего контент-маркетолога: необходимые знания и навыки для старта, плюшки и головная боль. Все здесь....
23 10 2026 14:58:49
 Что нужно знать о целевой аудитории, как грамотно воровать у других и что нужно сделать, чтобы настроить идеальную рекламную кампанию....
22 10 2026 2:13:38
Компании и продукты, социальные инициативы, главные проекты и миссия группы. Разложили все о Netpeak Group по полочкам в новом посте....
21 10 2026 7:27:49
 Минимизация пропущенных звонков и ускорение обработки заявок с наглядными примерами из сервиса...
20 10 2026 2:20:51
 Инсайты Диви Конф 2021, онлайн-конференции о видеомаркетинге....
19 10 2026 12:42:41
 Про работу мозга и запоминание из книги Торкеля Клинберга «Информационный поток и пределы рабочей памяти» и обзор игр Lumosity....
18 10 2026 3:40:45
 Один из самых известных отчетов в Google ***ytics «Аудитория/Обзор». Но кроме него есть еще несколько, которые будут весьма полезны для вашего блога. Какие именно, читайте дальше....
17 10 2026 14:51:33
Как настроить просто и быстро настроить скрипт в Google ***ytics для отслеживания печати страниц сайта....
16 10 2026 22:59:35
 Алгоритм ссылочного ранжирования, который показывает ее значимость, в частности, для поисковиков. Важность показателя PageRank оспаривают, но до сих пор считают. Читать!...
15 10 2026 2:44:46
 Как повысить результаты продаж в режиме цейтнота. Советы новому руководителю от специалистов Netpeak Group. Больше подробностей — в посте...
14 10 2026 5:57:34
 Каждый владелец знает, что залог успеха эффективного продвижения кампаний — качественная ежедневная оптимизация, а эксперименты — путь к новым горизонтам и еще более качественным результатам...
13 10 2026 5:18:20
 Представляем Netpeak Journal — новый этап развития блога Netpeak...
12 10 2026 1:40:58
Кратко об аутрич-продвижении? Размещайте полезный контент с ссылками на ваш сайт на качественных ресурсах. Хотите подробности — читайте новую статью....
11 10 2026 17:33:18
 Как надолго завоевать доверие покупателя с помощью грамотного email-маркетинга? Примеры обращений к клиенту в рассылках, текст писем для привлечения и благодарности за покупку....
10 10 2026 22:31:56
 Семнадцать крутых шагов к эффективному бренду Заг — это авторский неологизм от слова зигзаг (англ. zigzag). Он подразумевает движение в другом направлении....
09 10 2026 12:35:20
 Крупным брендам не избежать негатива в сети. Но с ним можно и нужно работать. Читайте успешный кейс для DOM.RIA....
08 10 2026 15:46:53
 Николь Лаззаро из XEODesign провела исследование о том, почему мы играем или не играем в игры....
07 10 2026 6:52:12
 Как сделать красиво. Алгоритм подготовки красивых и понятных презентаций, рекомендации и полезные ссылки, а также простые правила хорошего тона в дизайне Google Презентаций. Узнать больше и сделать свою презентацию эффективнее!...
06 10 2026 15:58:34
 Подборка ненаучных наблюдений и ситуаций, в которых бывал каждый из нас...
05 10 2026 14:56:21
 База самых распространенных CMS и модулей для их SEO-оптимизации....
04 10 2026 10:41:28
 Грамотная группировка поисковых запросов позволяет максимально увеличить поисковой трафик....
03 10 2026 10:54:17
 Как оптимизировать и выжать максимум пользы из сниппетов сайта в выдаче Google и Яндекс...
02 10 2026 20:15:34
 Сайту нужны внешние ссылки на сторонних ресурсах. Они могут повлиять на ранжирование вашего ресурса и трафик, а один из методов их получить — аутрич....
01 10 2026 23:23:23
 Одесса. Конференция «Контекстная реклама 2013». Самые полезные настройки рекламной кампании....
30 09 2026 9:38:51
 Решили написать про новый формат рекламы — баннерный...
29 09 2026 0:18:27
 Netpeak Checker – это мультифункциональный инструмент для массового анализа и сравнения сайтов, который помогает выполнять самые разнообразные задачи в области интернет-маркетинга....
28 09 2026 4:10:57
Об особенностях реализации интернет-проектов в Великобритании, России и Казахстане и фишках успешного ведения бизнеса онлайн мы побеседовали с Владимиром Меркушевым — руководителем интернет-проектов успешной казахстанской компании Kolesa.kz....
27 09 2026 20:52:25
 Как создать и внедрить баннеры об использовании куки-файлов с помощью Google Tag Manager и OneTrust...
26 09 2026 18:57:34
 А ещё у нас появилась новая стратегия SEO-продвижения для ниши доставки еды и продуктов....
25 09 2026 2:12:50
 Настроенная бизнес-страница компании в Instagram и на Facebook помогает в продвижении товаров и услуг в интернете. Поэтому так важно сделать их seo-friendly. Читать!...
24 09 2026 13:17:18
 Как подготовиться и сделать из интервью полноценную историю, которая будет интересна аудитории...
23 09 2026 17:52:30
Не существует универсальных решений - есть эффективные инструменты и удачные их сочетания....
22 09 2026 5:47:59
 Как METRO Cash & Carry Украина нашла индивидуальный подход к 1 000 000 клиентов....
21 09 2026 23:38:57
 Кейс: новинки в продвижении рекламы интернет-магазина в контекстно-медийной сети Google...
20 09 2026 23:13:42
 Айти эксперт Женя Розинский о том, почему нацию айти развивают продуктовые бизнесы, а не outsourcing сервисы...
19 09 2026 1:39:39
 Клиентам не нужно ориентироваться на попадание к поисковым топам выдачи...
18 09 2026 7:29:33
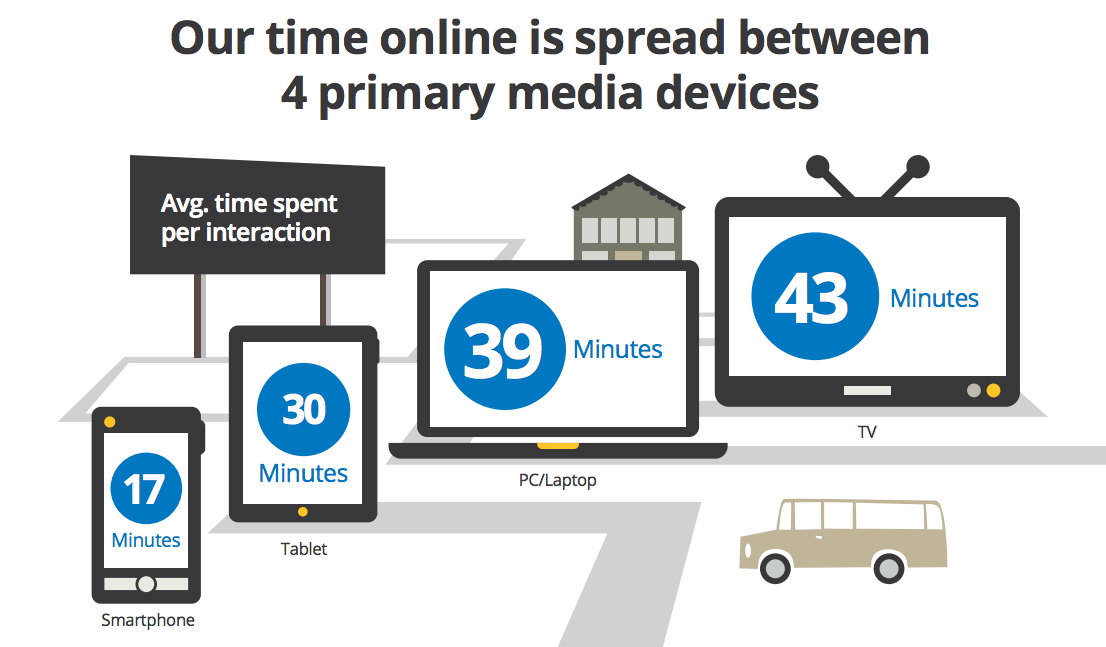 Пришло такое время — обновить данные, тем более что в начале сентября появилось исследование Google....
17 09 2026 23:24:47
 Google Adwords: типы рекламных кампаний и объявлений, тонкостях настройки... Все, о чем вы боялись спросить... Или не боялись, а просто не знали, о чем спрашивать....
16 09 2026 10:59:55
 Look-alike аудитории, таргетинг на участников групп, ограничение стоимости установки и другие вкусные фишки myTarget...
15 09 2026 0:27:37
 Продвижение сервисного центра техники Total Apple в Москве....
14 09 2026 15:15:13
Еще:
понять и запомнить -1 :: понять и запомнить -2 :: понять и запомнить -3 :: понять и запомнить -4 :: понять и запомнить -5 :: понять и запомнить -6 :: понять и запомнить -7 ::