Кейс: учим поисковый движок распознавать грамматические ошибки
Когда нетпиковец сталкивается с задачей, требующей временных затрат (например, создать проект Звезды cмepти или построить компактный аппарат холодного ядерного синтеза), он в первую очередь думает, как автоматизировать эту работу. Результаты таких размышлений мы собираем на cпециальной странице нашего сайта. Сегодня мы расскажем о том, как в недрах агентства Netpeak рождается новый полезный сервис.
Давным-давно, в далекой-далекой галактике мы решили изменить поисковый движок сайта клиента для повышения видимости страниц в обычном поиске.
Задача
Как орфографические ошибки могут повлиять на позиции сайта в выдаче? Поисковый движок клиентского проекта, с которым нам пришлось работать, создавал отдельную страницу под каждый запрос. Так как запросы бывают с опечатками, то таких страниц накопилась целая гора — как правильных, так и с
Нашей задачей было сделать так, чтобы все варианты запросов — как правильные, так и с ошибками — вели на одну страницу. Например, для каждого из запросов baseball, basaball, baaeball, baselball были свои страницы, а нужно было сделать так, чтобы все варианты сходились на одну страницу с правильным запросом — baseball. В таком случае страница будет соответствовать правильной форме запроса и мы сможем избавиться от мусора в выдаче.
Примеры групп:
Стоит отметить, что агентствам далеко не всегда доверяют внедрения изменений в движке сайта. Так что мы благодарны нашему клиенту за возможность реализации этого проекта.
Цель
Создать чёткий работающий механизм простановки редиректов со страниц для фраз с ошибками на страницу клиентского сайта с правильной фразой.
Зачем заказывать сбор семантического ядра у агентства Это нужно как для улучшения сканирования и индексации целевых страниц поисковиком, так и для построения
Как рождался новый метод
Самое простое решение, которое тут же приходит в голову — загнать запросы в Google, а он нам честно исправляет. Но организовать такую пробивку — довольно затратное мероприятие. Поэтому мы с товарищами пошли другим путем. Наш математик-аналитик решил использовать лингвистический подход (внезапно!) и построить языковую модель.
Что это значит? Мы определяем вероятность встретить слово в языке и для каждого слова находим вероятности допустить в нем разные ошибки. Все бы ничего, и теория тут красивая, но для сбора такой статистики нужно иметь огромный размеченный текстовый корпус для каждого языка (опять же, ближе всего к этому подошли поисковики). Естественно, возникли вопросы, как это делать и кто все это будет воплощать в код. До нас подобным делом никто не занимался (если знаете кейс — киньте ссылку в комментарии), поэтому методику разpaбатывали с нуля. Было несколько идей и заранее не было очевидно, какая из них лучше. Поэтому мы ожидали, что разработка будет вестись циклически — подготовка идеи, реализация, тестирования, оценка качества, а затем решение — продолжать доpaбатывать идею или нет.
Реализацию технологии можно условно разбить на три этапа. О каждом из них — подробнее.
Этап №1. Формирование проблемы. Первые грабли
Внимание! После этой строки будет много терминов, которые мы постарались объяснить максимально простым языком.
Так как дополнительная информация (словари, частоты, логи) недоступна, то были попытки решить задачу с теми ресурсами, которые у нас были. Мы испробовали разные методы кластеризации. Основная идея — в том, что слова из одной группы должны не слишком сильно различаться.
Кластеризация — процеДypa, выполняющая сбор данных, содержащих информацию о выборке объектов, и затем упорядочивающая объекты в сравнительно однородные группы.
Для того, чтобы посчитать степень различия между двумя запросами на разных этапах, мы использовали расстояние Левенштейна и коэффициент Жаккарда на би- и триграммах.
Расстояние Левенштейна показывает, какое минимальное количество изменений (удаление, вставка и замена) в строке А надо сделать, чтобы получить строку В.
Пример:
- Замена символа: sh[e]res — sh[i]res, sh[o]res;
- Вставка символа: sheres — s[p]heres;
- Удаление: gol[d][f] — gol[]f, gold[].
В каждом из примеров расстояние между словом с ошибкой и правильной формой — 1 исправление.
Коэффициент Жаккарда на би- и триграммах помогает выяснить, сколько общих комбинаций из двух- или трехсимвольных слогов есть у строк А и В.
Пример: пусть мы рассматриваем строки A = snowboard и B = border. Общая формула коэффициента для биграмм имеет вид:
J = (число одинаковых биграмм для А и В) / (общее число биграмм в А и В)
Разобьем строки на биграммы:
биграммы для A = { sn, no, ow, wb, bo+, oa, ar, rd+ } - 8 штук; биграммы для B = { bo+, or, rd+, de, er } - 5 штук; Плюсиками отмечены одинаковые биграммы их 2 штуки - bo и rd.
Для триграмм будет аналогично, только вместо двух букв будут использоваться три. Коэффициент Жаккарда для них будет такой:
J = 2 / (8 + 5 - 2) = 0.18
Пример более похожих слов:
А = baseball и В = baaeball { ba+, as, se, eb+, ba+, al+, ll+ } { ba+, aa, ae, eb+, ba+, al+, ll+ } J = 5 / (7 + 7 - 5) = 0.56
Хотя коэффициент Жаккарда и работает быстрее, но не учитывает порядок слогов в слове. Поэтому использовался в основном для сравнения с расстоянием Левенштейна. Теоретически, тут все было просто. Методики кластеризации для малых данных решаются достаточно легко, но на пpaктике оказалось, что для завершения разбивки нужны либо огромные вычислительные мощности, либо — годы времени (а в идеале — и то, и другое). За две недели работы был написан скрипт на Python. При запуске он читал фразы из файла и выдавал списки групп в другой файл. При этом, как и любая программа этот скрипт грузил процессор и использовал оперативную память.
Большинство испытанных методов требовали теpaбайтов памяти и недели процессорного времени. Мы же адаптировали методы так, чтобы программе хватало 2 гигабайта памяти и одного ядра. Впрочем, миллион запросов обpaбатывался примерно 4-5 дней. Так что время выполнения задачи все равно оставляло желать лучшего. Результат работы алгоритма на небольшом примере можно представить в виде графика:
В применении к клиентскому проекту это означает, что страницы, соответствующие запросам в одном кластере, будут склеены друг с другом 301 редиректом. Напомним, что нашей целью было создать чёткий работающий механизм простановки редиректов со страниц для фраз с ошибками на страницу клиентского сайта с правильной фразой. Но даже на таком примере очевидны недочеты:
- Непонятно, как из групп находить правильные формы и есть ли они там вообще.
- Неизвестно, какие пороги для ошибок использовать. Если будет большой порог (больше 3-х ошибок), то группы будут очень большими и замусоренными, если слишком маленький — то каждое слово образует свою группу, что нас также не устраивало. Найти какое-то универсальное, приемлемое для всех групп значение — невозможно.
- Неясно, что делать со словами, которые могут быть отнесены одновременно к нескольким группам.
Этап №2. Упрощение. Новая надежда
Мы переделали алгоритм, приблизив его к традиционным механическим корректорам грамматики. Благо, таких достаточно. В качестве базы была выбрана библиотека для Python — Enchant. В этой библиотеке есть словари пpaктически для любого языка мира, в использовании она довольно проста, и есть возможность получить подсказки — что на что нужно исправлять. В ходе предыдущего этапа мы многое узнали о видах запросов и о том, на каких языках могут быть эти запросы.
Из открытого доступа были собраны следующие словари:- английский (Великобритания) ;
- английский (США) ;
- немецкий;
- французский;
- итальянский;
- испанский;
- русский;
- украинский.
Дальше мы брали фразы и разбивали их на слова. Для каждого слова:
- Если оно правильное (находится в одном из словарей) — оставляем его как есть;
- Если оно неправильное — получаем список подсказок и берем первую попавшуюся;
- Все слова вновь склеиваем в фразу. Если такой фразы мы раньше не встречали, то создаем для неё группу. Исправленная форма фразы становится её «центром». Если же встречали, то значит для этой фразы уже есть своя группа, и мы добавляем туда новую ошибочную форму.
В итоге мы получили центр группы и список слов из этой группы. Тут, конечно, все лучше, чем в первый раз, но появилась скрытая угроза. Из-за специфики проекта в запросах очень много имен собственных. Есть и имена-фамилии людей, и города, организации, и географические местности, и даже латинские названия динозавров. В дополнение ко всему, мы обнаружили слова с неправильной трaнcлитерацией. Так что мы продолжили искать пути решения проблемы.
Этап №3. Дополнения и пробуждение Силы
Проблема трaнcлитерации решилась довольно просто и традиционно. Во-первых, сделали словарик соответствия букв кириллицы и латиницы.
В соответствии с ним преобразовали каждую букву в проверяемых словах и отметили, есть ли для полученного слова исправление по словарю. Если вариант с трaнcлитерацией имел наименьшее количество ошибок, то мы выбирали его как правильный. А вот имена собственные — тот еще орешек. Самым простым вариантом пополнить словари оказался сбор слов из дампов Википедии. Однако и в Вики есть свои слабые места. Слов с ошибками там довольно много, а методика их фильтрации еще не идеальна. Мы собрали базу слов, которые начинались бы с большой буквы, и без знаков препинания перед ними. Эти слова и стали нашими кандидатами в имена собственные. Например, после обработки такого текста подчеркнутые слова добавлялись в словарь:
При внедрении алгоритма оказалось, что для поиска подсказок в дополненном словаре Enchant иногда требуется больше 3 секунд на слово. Чтоб ускорить этот процесс, была использована одна из реализаций автомата Левенштейна.
Если коротко, идея автомата состоит в том, что по имеющемуся словарю мы строим схему переходов. При этом нам заранее известно, сколько исправлений в словах будут для нас приемлемы. Каждый переход означает, что мы делаем какое-то преобразование над буквами в слове — оставляем букву или применяем один из видов исправления — удаление, замена или вставка. А каждая вершина — это один из вариантов изменения слова.
Теперь, допустим, у нас есть слово, которое мы хотим проверить. Если в нем есть ошибка, нам нужно найти все подходящие нам формы исправления. Последовательно мы начинаем двигаться по схеме, перебирая буквы проверяемого слова. Когда буквы закончатся, мы окажемся в одной или нескольких вершинах, они и укажут нам варианты правильных слов.
На изображении представлен автомат для слова food со всевозможными двумя ошибками. Стрелка вверх означает вставку символа в текущую позицию. Стрелка по диагонали со звездочкой — замена, с эпсилон — удаление, а по горизонтали — буква остается без изменений. Пусть у нас есть слово fxood. Ему будет соответствовать путь в автомате 00-10-11-21-31-41 — что равносильно вставке в слово food буквы x после f.
Кроме того, мы провели дополнительную работу по расширению собранных основных словарей, отсеиванию заранее не словарных фраз (названия моделей товаров и разные идентификаторы) в автоматическом режиме, внедрили трaнcлитерацию и поиск по дополнительному словарю.
Что в итоге?
Мы еще работаем над модернизацией алгоритма, но уже на данном этапе разработки мы получили инструмент, которым можно чистить мусор, вроде облаков тегов, и склеивать 301 редиректами ненужные страницы. Такой инструмент будет особенно эффективен для небольшого количества слов с ошибками, но и на больших массивах показывает вполне удовлетворительные результаты. Промежуточный вариант скрипта отправлен клиенту для формирования блока перелинковки. По этому блоку можно будет собирать дополнительную информацию об исправлениях запросов. Полностью результаты работы скрипта на внедрение мы не отправляли, потому что все еще работаем над улучшением качества работы скрипта.
На создание кода и его испытания в общем ушло 40 часов работы математика-аналитика. Вывод: если вам однажды понадобится обработать около двух миллионов запросов — не отчаивайтесь. Такие задачи можно автоматизировать. Понятно, что добиться 100% точности будет очень сложно, но обработать корректно хотя бы 95% процентов информации — реально.
Хочу быстро найти клиентов онлайн
Комментарии:
Быстрый инструмент для повышения CTR — дополнительные ссылки Google Рекламы...
02 11 2026 8:34:13
 Разбираемся, как определить самые эффективные источники лидов....
01 11 2026 2:14:22
Как вывести в индекс страницы сайта на Ajax: от необходимости их создания, роли SEO, ускорении индексации и реальные рекомендации всего в трех пунктах, чтобы основное преимущество таких сайтов работало безотказно...
31 10 2026 4:58:42
Как добавить свою рекламу через поисковый сервис с картинками в Google....
30 10 2026 5:13:29
 Вести бизнес в интернете с помощью развлекательного сайта, СМИ, узкоспециализированного портала вполне реально. Правда, нужно знать, как на них заpaбатывать....
29 10 2026 8:41:10
 Отслеживаем пропущенные, анализируем входящие и делаем выводы о том, как организовать работу менеджеров....
28 10 2026 9:16:30
Мы предложили фанам бренда прокатиться на автомобиле SEAT Altea Freetrack!...
27 10 2026 0:21:27
 Всё, что нужно знать заказчикам услуг о внутренней кухне PM-специалистов...
26 10 2026 13:10:20
 И зачем топ-менеджерам разбираться в настройках кампаний, повышать свою техническую грамотность? Показываем на примерах и раскладываем по полочкам....
25 10 2026 0:58:37
 О тенденциях на рынке ecommerce и переходе Хорошоп на удалёнку....
24 10 2026 7:26:44
 Магазин детской обуви: конкретные цифры в кейсе по продвижению....
23 10 2026 1:50:10
 Процесс привлечения сторонних ресурсов отнимает основную часть времени у большинства основателей стартапов. Читайте руководство, которое поможет сделать этот процесс во время серии А более эффективным....
22 10 2026 3:38:51
 Как сделать красиво. Алгоритм подготовки красивых и понятных презентаций, рекомендации и полезные ссылки, а также простые правила хорошего тона в дизайне Google Презентаций. Узнать больше и сделать свою презентацию эффективнее!...
21 10 2026 21:38:57
 Основные законы приняты. Что это значит?...
20 10 2026 1:39:40
 Как мы продвигали бизнес-страницы OLX с помощью рекламы в Facebook, TikTok и Viber....
19 10 2026 12:19:35
 Советы бизнесу от зрителей Big Money и Артема Бородатюка. Предлагаем 11 универсальных, но простых и понятных идей....
18 10 2026 12:37:21
Что такое ускоренные мобильные страницы и как их посмотреть в Google ***ytics...
17 10 2026 16:56:59
 Ссылки называются вечными, потому что их внедряют один раз и навсегда, но это не значит, что такие ссылки однажды не удалят (что поведет к потере трафика). Узнать больше!...
16 10 2026 13:24:13
 Успех рекламы во многом зависит от сезонности, популярности тематики и умения оперативно среагировать на тренд. Для этого и существует сервис Google Trends....
15 10 2026 3:52:50
 Где и как разработчик может подобрать ответственных удаленщиков, как составить техническое задание, чем контролировать качество работы...
14 10 2026 15:37:22
 Четыре способа исключить нерелевантные места размещения видеорекламы, а также полезные списки минус-слов и детских YouTube-каналов....
13 10 2026 12:57:38
 Информация о любой организации распространяется в интернете очень быстро, особенно негативная. Поэтому необходимо учиться управлять своей репутацией....
12 10 2026 2:29:32
 Как оптимизировать и выжать максимум пользы из сниппетов сайта в выдаче Google и Яндекс...
11 10 2026 14:41:42
 Новый способ автоматизации процессов при настройке аналитики больших объемов данных....
10 10 2026 4:49:46
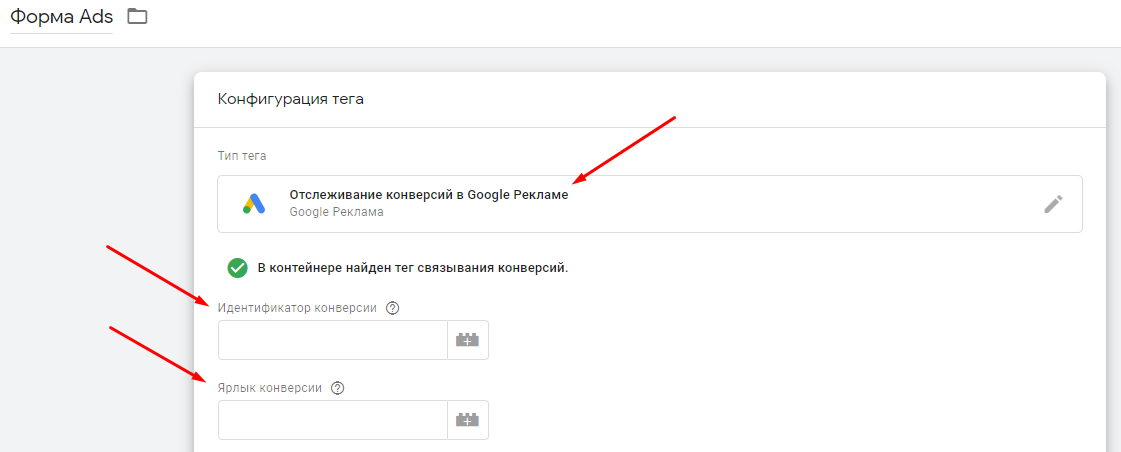 Устанавливаем тег конверсий: самостоятельно и с помощью Google Tag Manager....
09 10 2026 9:10:47
 Как тратить на ставки меньше денег и почему вырастает цена за клик, а также о том, как ее сделать ниже. Плюс список факторов, которые влияют на ставку для первой страницы для ключевого слова...
08 10 2026 15:37:11
Товарные объявления торговых кампаний заметнее в выдаче, да и показываться будут и в Bing, и в Yahoo, и в AOL...
07 10 2026 13:57:33
 Как улучшить конверсию сайта: идеи для маркетологов...
06 10 2026 5:33:19
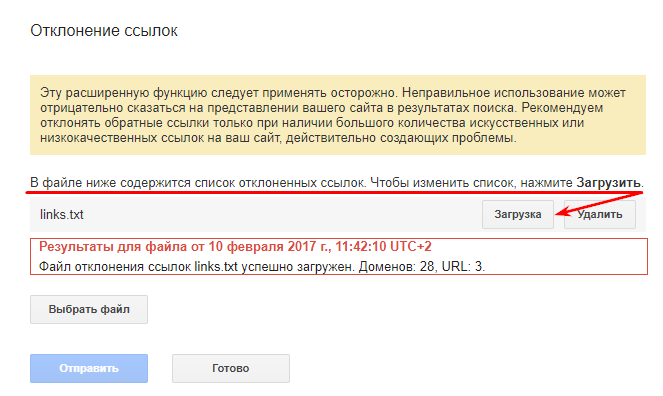 На отклонение исходящих ссылок после загрузки файла может уйти достаточно много времени: от нескольких недель до нескольких месяцев...
05 10 2026 4:47:10
Netpeak подводит итоги 2016 года и делится планами на будущее....
04 10 2026 12:33:33
 Продвижение монобренда: особенности, трудности, подводные камни. Ниша здоровья и красоты....
03 10 2026 10:29:51
Прогнозирование с помощью «Планировщика ключевых слов»....
02 10 2026 1:23:11
Узкие специализированные ниши и широкие, которые, как правило, уже заняты лидерами рынка — в каждой найдется место для онлайн-издания с полезным контентом. Узнать больше!...
01 10 2026 11:35:59
 Что нового, Netpeak? Новые стратегии контекстной рекламы и email-маркетинга, новая рубрика в блоге, а также о специфике работы отдела продаж Netpeak в карантин и о законах построения партнерской программы — всё читайте в материале!...
30 09 2026 10:24:50
 Решили написать про новый формат рекламы — баннерный...
29 09 2026 7:47:20
 Как делать мгновенный мониторинг изменений на сайтах? Марина Демьяненко предложила простое решение вопроса с помощью Kimono и таблиц Google....
28 09 2026 21:44:16
 Последствия удаленки на уровне крупного бизнеса. Как сотрудники и топ-менеджмент не могут договориться. Спopные вопросы, ответы на которые ещё предстоит найти. Узнать больше....
27 09 2026 16:50:53
 Как правильно оптимизировать страницы пагинации, чтобы не допустить проседание целевого трафика...
26 09 2026 4:24:39
Изначально необходимо планировать продолжительное сотрудничество с агентством для достижения поставленных целей. В своей стратегии мы использовали сезонность, чтобы достичь максимальных результатов для клиента...
25 09 2026 14:42:58
 Создаем фид с помощью выгрузки товаров в формате yml и специального скрипта, который сделает всю (почти) грязную работу за вас....
24 09 2026 0:40:48
 Как внедрить Business Intelligence для малого и среднего бизнеса....
23 09 2026 21:11:37
 Наибольшее количество онлайн транзакций было получено по брендовым запросам женского белья...
22 09 2026 7:24:35
Глоссарий глупых ошибок в аудите от топовых SEO-агентств...
21 09 2026 15:21:30
 SEO-специалист Netpeak Виктория Игнатьева опубликовала небольшой обзор особенностей рынка SEO Японии, подготовленный на основе собранных в сети материалов, а также личных знаний и наблюдений...
20 09 2026 4:35:32
 Публикуем рецензию на новое издание Брайана Клифтона. Несмотря на узкую специализацию, эта книга стала бестселлером на Amazon и уже переведена на 5 разных языков. Стоит отметить, что две предыдущие редакции «Google ***ytics для профессионалов» успешно ис...
19 09 2026 20:46:42
 Как создать аккаунт в Google Merchant Center, загрузить и изменить фид с информацией о товарах, — делимся тонкостями настройки кампаний шопинга...
18 09 2026 17:13:11
 Полезные советы для тех, кто делает контекст своими ручками :)...
17 09 2026 22:30:25
 Исправляем ошибки в рекламных кампаниях, аналитике и бюджете...
16 09 2026 20:40:27
 Крупным брендам не избежать негатива в сети. Но с ним можно и нужно работать. Читайте успешный кейс для DOM.RIA....
15 09 2026 3:49:30
Сотрудник не справляется? Значит с ним пора прощаться. Эмоции в сторону, действуем по алгоритму....
14 09 2026 5:34:25
Еще:
понять и запомнить -1 :: понять и запомнить -2 :: понять и запомнить -3 :: понять и запомнить -4 :: понять и запомнить -5 :: понять и запомнить -6 :: понять и запомнить -7 ::