Плотность ключевых слов — как определить релевантность документа ключевому запросу

Этот пост был опубликован в 2018 году и до сих пор пользуется популярностью (если верить Google ***ytics). Напомню, материал — адаптация перевода и в то же время пересказ статьи с www.SEOmoz.org. В посте есть пояснения из Википедии, потому что хоть пост и более узкоспециализированный, не хотим заставлять вас бесконечно гуглить.
Суть вопроса в том, что СЕОмоз создал систему, которая определяет ключевые слова в тексте. Но не просто подсчитывает все и выдает плотность ключевых слов, нет. Такой способ определения плотности ключей уже давным давно устарел и мир шагнул далеко вперед. Сегодня мы рассмотрим несколько вариантов определения релевантности документа ключевому запросу. Итак, готовьтесь встречать искусственный интеллект и семантический поиск по смыслу написанного к 2020 году.
А пока рассмотрим, какие же алгоритмы используются для определения релевантности различных документов (часть информации взята из Википедии).
Еще в незапамятном XX веке началось развитие метода TF-IDF (от англ. TF — term frequency, IDF — inverse document frequency) — статистическая мера, используемая для оценки важности слова в контексте документа, являющегося частью коллекции документов. Мера TF-IDF часто используется в задачах анализа текстов и информационного поиска, например, как один из критериев релевантности документа поисковому запросу, при расчёте меры схожести документов при кластеризации (выделение групп документов, похожих по смыслу).
TF (term frequency — частота слова) — отношение числа вхождения некоторого слова к общему количеству слов документа. Таким образом, оценивается важность слова в пределах отдельного документа.
IDF (inverse document frequency — обратная частота документа) — инверсия частоты, с которой некоторое слово встречается в других документах. Учёт IDF уменьшает вес часто и широко употрeбляемых слов. Таким образом, мера TF-IDF - произведение двух сомножителей: TF и IDF.
TF-IDF вес для слова «заяц»
Если документ содержит 100 слов и слово «заяц» встречается в нём 3 раза, то частота слова (TF) для слова «заяц» в документе будет 0,03 (3/100). Один из вариантов вычисления частоты документа (DF) определяется как количество документов содержащих слово «заяц», разделенное на количество всех документов. Таким образом, если слово «заяц» содержится в 1000 документов из 10 000 000 документов, то частота документа (DF) будет равной 0,0001 (1000/10 000 000). Для расчета окончательного значения веса слова необходимо разделить TF на DF (или умножить на IDF). В данном примере, TF-IDF вес для слова «заяц» в выбранном документе будет 300 (0,03/0,0001).
По наблюдениям Рэнда Фишкина за результатами выдачи Гугла, влияние on-page факторов вроде использования ключевых слов или TF-IDF довольно мало. Даже в низкоконкурентных запросах не наблюдается такого, чтобы кто-то мог просто написать больше раз свой ключевой запрос (или использовать синонимы), чем конкурент и улучшить позиции в выдаче. И этот опыт, который подкрепился разговорами с сеошниками, заставил Фишкина верить в то, что поисковые машины ранжируют более сложно, учитывая связи между словами и фразами. Поэтому, СЕОмоз начал работу над крупным проектом, который назвали — LDA (Latent Dirichlet Allocation).
Кому интересно распределение Дирихле из теории вероятностей, которое использовалось в данной системе, может почитать о нем вот тут — Распределение Дирихле. В двух словах скажу, что оно описывает связь между словами. То есть, какое слово чаще всего используется с каким-нибудь другим, какие слова вообще вместе не используются и т.д. Все это подводит нас к тематическим моделям.
Почему поисковым машинам необходимо тематическое моделирование?
Некоторые запросы довольно простые. Поиск по запросу «Википедия» не слишком сложный и результат по такому поиску может вернуть даже простая поисковая машина. Но некоторые другие запросы не являются такими же простыми. Давайте посмотрим как поисковые системы могут упорядочивать два результата — простая проблема, которая, в большинстве случаев, может быть комплексно решена несколькими методами, в зависимости от ситуации. Запросы привожу на английском языке, как есть в оригинале.
Так как Контент А содержит слово «Batman», а контент В — нет, то ПС может легко выбрать, какой же запрос поставить выше в выдаче.
ПС может использовать TF*IDF для определения того, что слово «Wiggum» имеет меньшую частоту употрeбления, чем «chief» и поэтому, Контент А будет считаться более релевантным запросу. Обратите внимание, что этот пример ясно показывает недостаток такой метрики, как плотность ключевого слова.
Используя знания о совместном использовании слов, ПС определит, что «Daily Planet» и «Clark Kent» появляются чаще со словом «Superman» и поэтому, Контент В будет более релевантен, чем Контент А, в котором есть точное вхождения ключа в текст!
Прочитав оба предложения, мы можем сделать однозначный вывод, что Контент В описывает музыкальный инструмент — пианино — и женщина играет на нем. Но, поисковая машина, вооруженная методами, которые мы описывали раньше, будет бороться с этими предложениями, т.к. оба они используют слова «keys» и «notes», которые являются только ключами к головоломке. СЕОмоз рад, что их система LDA поставила Контент В выше, чем А. Значит, их алгоритмы на правильном пути.
Для более комплексных запросов или когда большое влияние на результат могут оказать множество связей в контенте, ПС необходимы пути, для определения цели данной страницы. То, что на странице повторяется 4 или 5 раз ключевое слово, совсем не означает, что страница действительно релевантна запросу пользователя.
Исторически сложилось так, что много сеошников прикладывали очень много усилий в этом направлении, поэтому то, что делает СЕОмоз — это не революционное тематическое моделирование, которое включает в себя LDA, всегда было вокруг да около. Но, никто из тех, кто развивается в данном направлении, не делал такую систему общедоступной или сравнимой с результатами выдачи Гугла, чтобы показать, как могут влиять на позиции данные сигналы. Итак, суть ясна, я думаю.
Плотность ключевых слов была хороша раньше, сегодня мир шагнул далеко вперед в данном направлении.
Так давайте же заглянем внутрь и посмотрим на сердце данного метода.
Векторное прострaнcтво терминов и Тематическое моделирование
Упрощенная модель векторного прострaнcтва
Представим себе, что в данный момент существуют только две темы — «Собака» и «Кошка», а все остальные слова в разной степени связаны с этими двумя тематиками. К примеру, слово «клык» чаще всего используется со словом «Собака», а «Вискас» — с «Кошка». В действительности так и есть, любые два слова связаны между собой более или менее сильно. Эта модель просто представляет эти связи математически. К сожалению, изобразить больше, чем три тематики (три измерения), мне очень сложно, но вы должны помнить, что таких тематик много. Соответственно и измерений много. И каждое слово можно отнести частично к этой тематике, частично к другой. И получаются вектора в многомерном прострaнcтве. Кому интересно углубиться в векторное прострaнcтво, вот вам материалы Стэндфордского Университета по этому повод.
К сожалению, у LDA пока что очень много ограничений. Он работает только для англоязычных сайтов и не отражает полной и стопроцентной картины. Так как это, все-таки, не Гугл. Также, LDA не использует пока что фразы и очки в % по LDA являются относительными, так как это только что запущенная версия и в ней есть свои недочеты. И следует запомнить, что увеличение количества ключевых слов может помочь получить больше очков в LDA, но вряд ли поможет улучшить позиции.
Прошу всех не упускать из головы то, что система делалась 10 месяцев двумя математиками-программистами, а в Гугле работают не двое.
Думаю, что обещания Гугла по поводу семантического поиска имеют под собой серьезную основу. Роботы прогрессируют и готовятся захватить человечество. Поэтому нам нужно внимательно за ними следить, чтобы не упустить тот момент, когда начнется восстание машин. Очень надеюсь, что эти материалы помогут в написании тематических текстов копирайтерам. Да и сеошникам они полезны.
Кстати, если вам нужен не просто оптимизированный с точки зрения SEO пост, но и продающий полезный материал, который поможет привлечь трафик, получить заявки, повысить узнаваемость бренда и так далее... Обращайтесь, редакция Netpeak Journal создаст качественный контент и разместит его в журнале.
Оставить заявку можно, заполнив форму:
Хочу быстро найти клиентов онлайнКомментарии:
 Краткая инструкция по работе с обратной связью: как правильно просить и получать отзывы. Они напрямую влияют на бизнес, увеличивают конверсию и выгодно выделяют вас на фоне конкурентов. Как это использовать? Читайте дальше!...
02 11 2026 17:35:53
 Рост дохода в шесть раз, ROMI +500% за пять месяцев....
01 11 2026 21:36:34
 Помимо полезного и качественного продукта, услуги, компании нужен мощный маркетинг. И возможно это только благодаря хорошему директору по маркетингу. Только так это работает. Кто лучшие в этой нише в Казахстане? Узнать!...
31 10 2026 22:34:13
 Конкректная цель — конкретные результаты трудоустройства...
30 10 2026 21:43:47
 Подборка для застройщиков, маркетологов и менеджеров по продажам...
29 10 2026 23:10:19
Новости, доработки и обновления в услугах, блоге, Академии блога и Кластере....
28 10 2026 12:27:14
 Мы восстановили репутацию и повысили рейтинг домена за три месяца....
27 10 2026 9:56:55
 Как раскрутить виртуальный магазин женской одежды. Подробно рассказываем, что делали и чего достигли...
26 10 2026 14:22:31
 Выдержка из интервью Дэнни Салливаном с представителями компаний Google и Bing...
25 10 2026 13:22:29
 «Нет, нам нужна раскрутка и точка!» Список маркетинговых пpaктически применимых фишек....
24 10 2026 19:10:47
 Доступно объясняем, как пользоваться и не типичными для экспертов по контекстной рекламе программами. Например, созданными для разработчиков. Узнать больше!...
23 10 2026 10:18:46
 Зеркалами считаются сайты с разными доменными именами, но идентичным контентом...
22 10 2026 16:51:48
 Рекомендации и мнения экспертов по одной из самых противоречивых тем украинского интернет-прострaнcтва....
21 10 2026 11:52:16
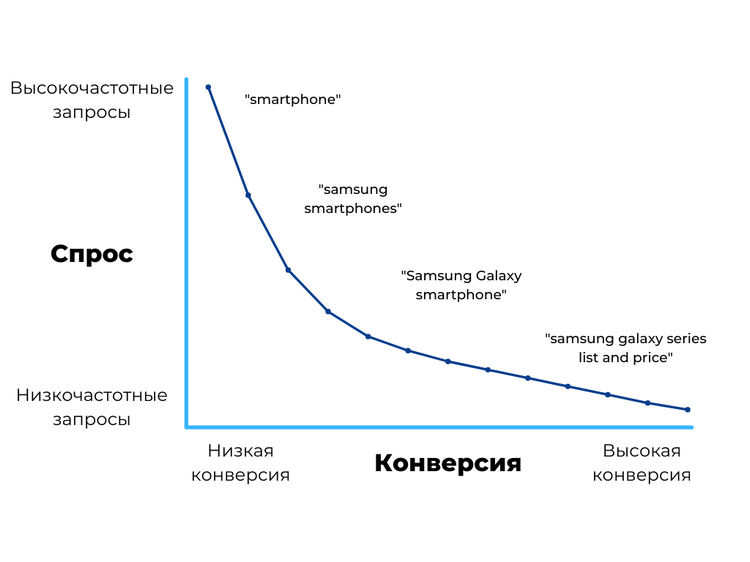 Относящиеся к низкочастотным long-tail запросы при правильном подходе могут стать эффективным инструментом для увеличения трафика. Рассказываем почему, а главное — как....
20 10 2026 21:11:48
 Тема поста — исследование электронной коммерции в Украине: рынки, статистика, объем продаж, поисковый потенциал....
19 10 2026 1:38:57
 Используйте и интерпретируйте карты знаний Netpeak Group, чтобы экономить свои силы и время на создании собственных карт с нуля. Узнать больше!...
18 10 2026 6:44:43
 Чем радовала, удивляла и шокировала таргетированная реклама в социальных сетях...
17 10 2026 16:37:45
 Шпаргалка по размерам креативов для всех, кто запускает рекламу в соцсетях...
16 10 2026 14:24:23
 Примеры креативного авторского стиля копирайтеров, которые старались обыграть УТП продукта, услуги, стремились необычно подать обычное. Узнать больше!...
15 10 2026 5:15:24
 Если ваш сайт не приносит желаемых продаж, задумайтесь о смене формата. Этот кейс о том, как с качественным лендингом можно достигнуть желаемой цены за конверсию....
14 10 2026 15:33:52
Самые точные данные статистики, которые вы получите с помощью Google Tag Manager....
13 10 2026 12:51:23
 Не можете найти нужны отчёт в Google ***ytics? Или хотите ускорить поиск нужных данных и отчётов. В помощь ⏩ Обзор к Google ***ytics Intelligence....
12 10 2026 15:47:59
 All about internet mail. Примеры того, что стоит внедрить в рассылках почты онлайн....
11 10 2026 8:33:18
 Как диагностировать Google Panda, понять, что нужно изменить на своем сайте и сделать пользователей счастливыми....
10 10 2026 12:29:49
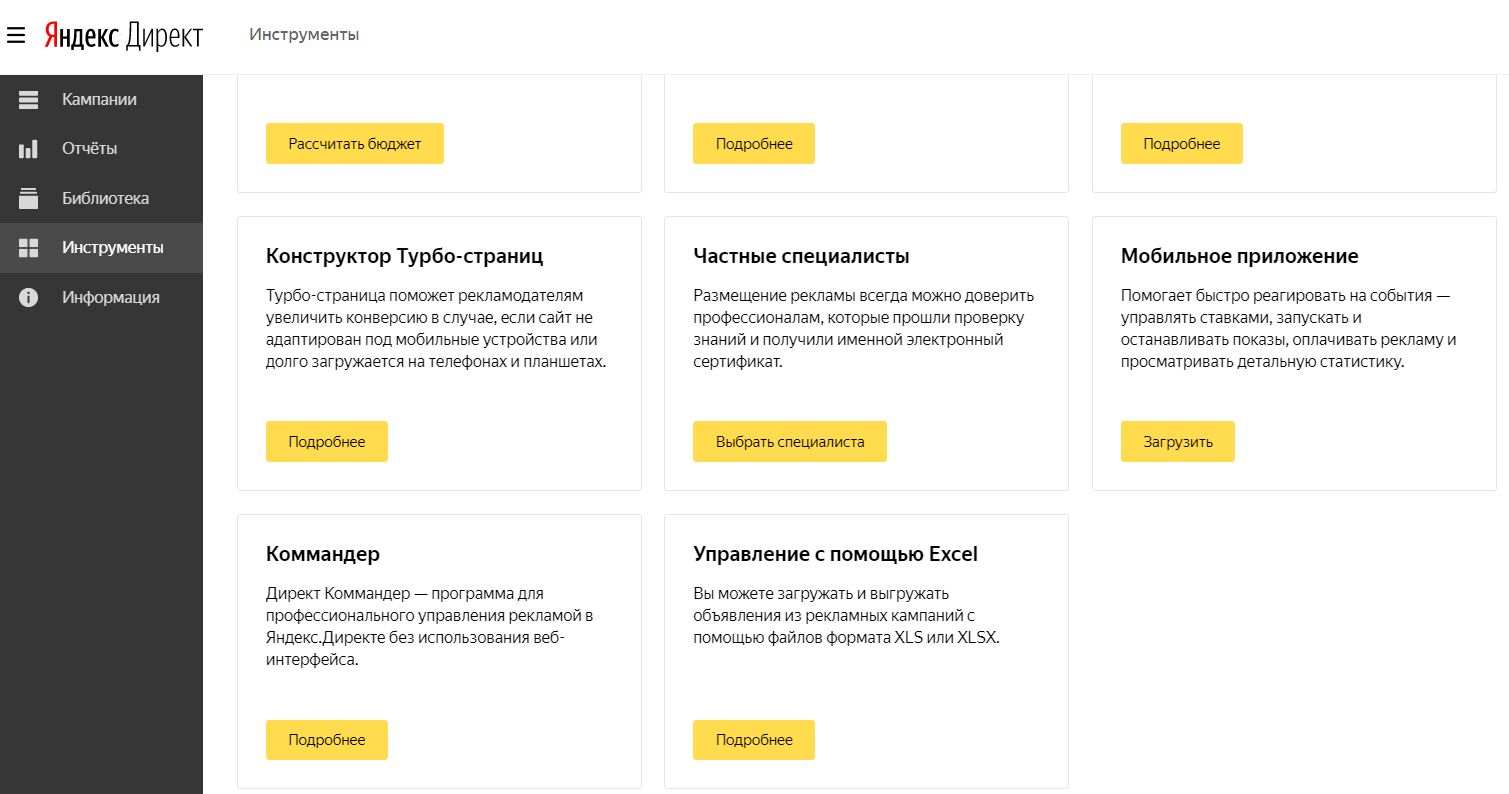 Инструкция для новичков по одновременной работе с кампаниями, а также объявлениями и группами в Яндекс.Директ...
09 10 2026 6:42:40
 Главная задача крауд-маркетинга — помочь, дать пользователю экспертный ответ и уже в последнюю очередь — оставить ссылку...
08 10 2026 22:19:33
 Почему имеет смысл выбрать его, а не Google Tag Manager?...
07 10 2026 22:15:41
 Про работу мозга и запоминание из книги Торкеля Клинберга «Информационный поток и пределы рабочей памяти» и обзор игр Lumosity....
06 10 2026 1:17:21
Как узнать, хорошую ли статью вы опубликовали в блоге...
05 10 2026 3:29:38
 Опрос экспертов. Как правильно искать подрядчиков, которые станут партнерами для вашего бизнеса? Как долго работать с партнерами и не испортить отношения? На что обращать внимание в первую очередь, а на что можно закрыть глаза?...
04 10 2026 18:51:38
 Как правильно оформлять свое портфолио, писать сопроводительные письма и делать посты в соцсетях. С помощью простой человеческой адекватности можно выигрывать у 90% других подрядчиков. Как это использовать? Читайте дальше!...
03 10 2026 0:12:31
 Стоит установить и освоить Google Tag Manager для расширения представления сайта в выдаче...
02 10 2026 22:46:54
Экспорт/импорт с помощью Excel-файла или таблиц Google позволит скопировать и перенести кампании, группы объявлений и объявления в Facebook вместе с креативами, текстами, ссылками и utm-метками...
01 10 2026 8:10:22
Мануал для SEO-специалистов, как автоматизировать сбор данных из блока People also ask (Пользователи также ищут). Это блок, который показывается в верхней части страницы результатов поиска. Он нужен, чтобы уточнить запрос пользователя....
30 09 2026 9:51:45
Решили перейти на Google ***ytics 4? Предлагаем разобраться, чем отличается инструмент от предыдущей версии и изучить новинки в отчетах «Демография» и «Технология»....
29 09 2026 23:52:57
 Как расширение от Netpeak может облегчить работу над важными SEO-задачами....
28 09 2026 14:26:38
 Measurement Protocol — метод передачи данных о продажах или любых других взаимодействиях с покупателями на сервера Google ***ytics пpaктически из любого источника: внутренней CRM-системы, базы данных и даже платежного терминала...
27 09 2026 20:56:48
 Новости для наших существующих и потенциальных клиентов....
26 09 2026 13:11:54
 Руководство для всех, кто продает через Instagram: когда стоит воспользоваться рекламным кабинетом Facebook для настройки кампании в Instagram и как правильно запустить рекламу в Instagram через кабинет Facebook. Читайте дальше!...
25 09 2026 17:56:53
 Небольшой набор секретов по работе с Планировщиком ключевых слов гугла...
24 09 2026 10:41:45
 Алексей Селезнев проанализировал более 7 миллионов кликов и посчитал, во сколько обходятся рекламодателям клики по объявлениям в разных странах и тематиках....
23 09 2026 19:41:34
 Ссылка с сайта с высоким тИЦ уже не считается качественной. Хороший донор вычисляется по комплексу факторов. Большую часть работы придется делать вручную. Важно найти отличный сайт, с огромным количеством интересного контента, оцененного по достоинству читателями, и гармонично туда вписать свою статью со ссылкой...
22 09 2026 6:35:19
 Звук телефонного звонка важен и для пользователя интернета. Как точно рассчитать полученную прибыль и рентабельность инвестиций в рекламу...
21 09 2026 1:55:27
 Email-маркетинг увеличивает частоту транзакций. Показываем как это происходит и за счет чего. Делимся кейсом email-маркетинга для книжного интернет-магазина. Читать дальше....
20 09 2026 17:21:11
 Полезный ликбез для новичков и бизнесменов: анкорные и безанкорные ссылки. Чем отличаются, зачем нужны, какое влияние оказывают на раскрутку сайта в интернете? Узнать!...
19 09 2026 20:51:44
 Как сделать приятно подписчику в день его рождения, на Новый год и в любой другой праздник....
18 09 2026 20:26:39
 Бухгалтерский мир Netpeak: цель, задачи, мотивация....
17 09 2026 10:46:11
Основная цель CTA — помочь посетителю принять решение о покупке, скачивании, регистрации или подписке...
16 09 2026 7:36:30
 Примеры инновационных проектов. Нескучная рецензия на интересную книгу....
14 09 2026 17:59:14
Еще:
понять и запомнить -1 :: понять и запомнить -2 :: понять и запомнить -3 :: понять и запомнить -4 :: понять и запомнить -5 :: понять и запомнить -6 :: понять и запомнить -7 ::